Yapay zeka agent’ları ile yazılım geliştirirken en kritik bütçeniz token’lardır.
Prompt’unuza eklediğiniz her token modeli yavaşlatır, maliyeti artırır ve context window’u doldurur. Context şiştikçe modeller basit hatalar yapmaya başlar: kuralları unutur, biçimlendirme ayrıntılarını gözden kaçırır ve çalışan kod yerine hatalı kod üretir.
Birçok geliştirici bu sorunu system prompt’larına daha fazla metin yığarak çözmeye çalışır. Uzun dosya şemalarını, biçimlendirme kılavuzlarını ve adım adım kontrol listelerini prompt’a yapıştırırlar. Prompt stuffing olarak bilinen bu yaklaşım, çoğu zaman işleri daha da kötüleştirir.
Bu makalede, süreci üç sade bileşene ayıran çok daha etkili bir yaklaşımı ele alıyoruz:
- Angarya biçimlendirme ve doğrulama işlerini üstlenen yerel bir CLI aracı.
- Yapay zekaya bu aracı nasıl kullanacağını öğreten kısa bir skill dosyası.
- Yalnızca ihtiyaç duyduğunda ilgili talimatları hafızasına yükleyen AI agent.
Şu an okuduğunuz makalenin yayına alınması da dahil olmak üzere, bu sitedeki (tahamertgokdemir.com) tüm içerik yönetimini tam olarak bu mimariyle yürütüyoruz. Gelin sistemin pratikte nasıl çalıştığına yakından bakalım.
1. Problem: Şişkin Prompt’lar Neden Çuvallar?
Statik site üreteciyle (örneğin bu sitenin kullandığı Hugo gibi) inşa edilmiş bir web siteniz olduğunu ve AI agent’ınızın yeni bir makale yayınlamasını istediğinizi düşünün.
Yapay zekanın bu işlemi manuel yapabilmesi için şunları eksiksiz başarması gerekir:
- Doğru dosya yolunu belirlemek (
content/article/<slug>.md). - Başlık, yerel saat dilimi farkını içeren ISO-8601 zaman damgaları, tahmini okuma süresi, kategoriler ve etiketler gibi kesin alanları barındıran karmaşık bir YAML frontmatter hazırlamak.
- 404 hatalarını önlemek adına slug değerinin sitenin permalink yapılandırmasıyla eşleştiğini doğrulamak.
- Etiketleri küçük harfli kebab-case dizisi olarak biçimlendirmek ve kategorinin onaylı taksonomiye uyduğundan emin olmak.
- Hugo şablonlarını veya HTML shortcode’larını bozmadan geçerli bir markdown yazmak.
Tüm bu kuralları system prompt’unuzda açıkladığınızda üç büyük problemle karşılaşırsınız:
- Her prompt’ta token israf edersiniz. Sadece CSS’teki ufak bir yazım hatasını düzeltmesini istediğinizde bile, model her turda statik kurallardan oluşan yüzlerce satırı baştan okur.
- Yapay zeka gözden kaçan hatalar yapar. LLM’ler mantık yürütmede harikadır; ancak saat dilimi hesaplamalarında, okuma süresi tahminlerinde veya YAML girintilerinde sıkça tökezlerler.
- Yapay zeka odak noktasını kaybeder. Context window’un yarısı bürokratik kurallarla dolduğunda, modelin net ve kaliteli teknik içerik üretmeye ayırabileceği dikkat kapasitesi azalır.
2. Çözüm: Üç Sade Katman
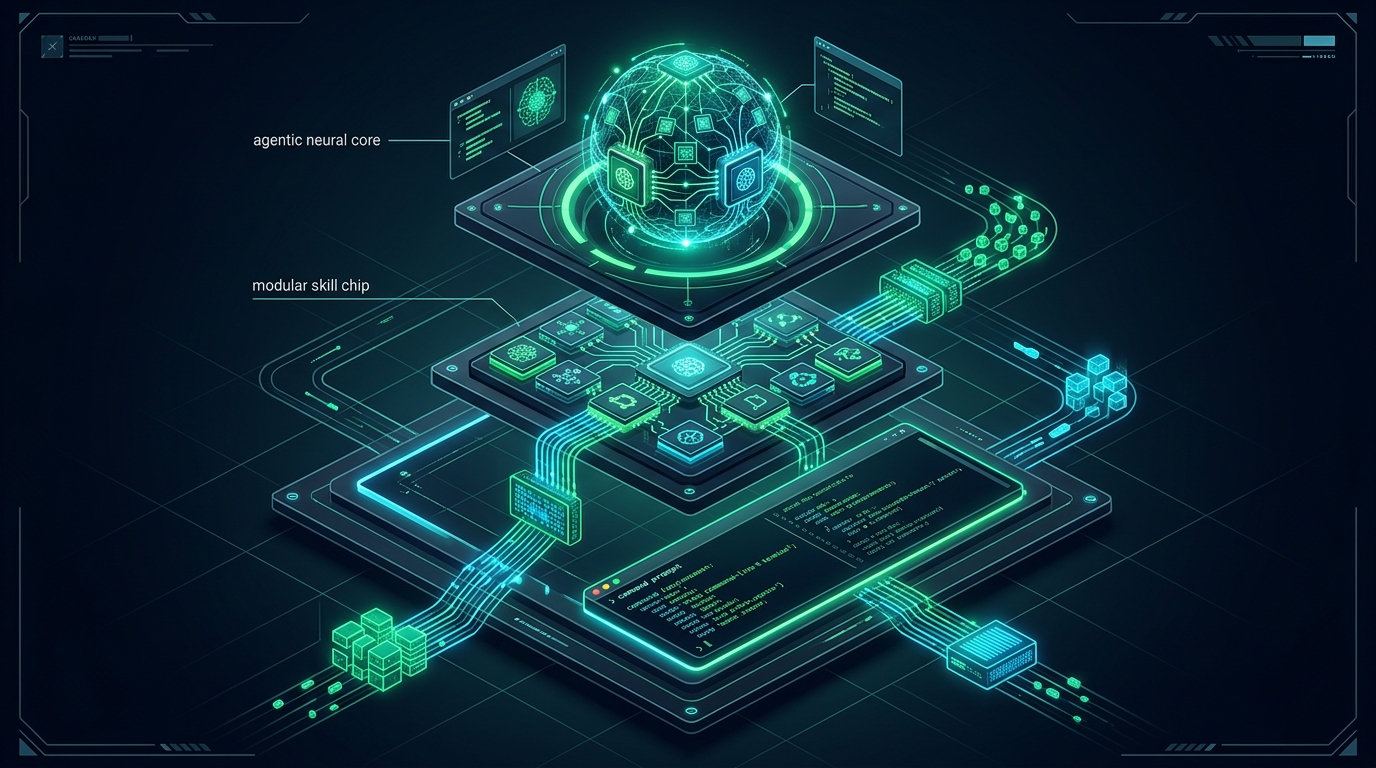
Yapay zekaya dosya kurallarını prompt context’inde ezberletmek yerine, iş akışını üç katmana ayırıyoruz:
  ┌───────────────────────────────────────────────────┐
  │                     AI Agent                      │
  │  Kullanıcı niyetini anlar ve ana görevleri yönetir│
  └─────────────────────────┬─────────────────────────┘
                            │
           Skill'i sadece gerektiğinde yükler
                            │
  ┌─────────────────────────▼─────────────────────────┐
  │             Skill Dosyası (SKILL.md)              │
  │  CLI flag'lerini ve kuralları içeren net rehber   │
  └─────────────────────────┬─────────────────────────┘
                            │
                    Komutu çalıştırır
                            │
  ┌─────────────────────────▼─────────────────────────┐
  │                 Yerel CLI (tahablog)              │
  │  Dosyaları üretir, YAML'ı yazar ve şemayı denetler │
  └───────────────────────────────────────────────────┘
Her katmanın işleyişini inceleyelim.
Katman 1: Yerel CLI Aracı (./tahablog)
İlk olarak, ./tahablog adında bağımsız bir Bash aracı geliştirdik.
Yapay zekadan YAML frontmatter’ını elle biçimlendirmesini veya tarih dizgilerini hesaplamasını istemek yerine, CLI tüm bu teknik yükü doğrudan üstlenir:
- Makale markdown dosyasını doğru dizinde oluşturur.
- Hugo’nun şemasıyla tam uyumlu, geçerli YAML frontmatter ekler.
- Yerel saat dilimi farkını (
+03:00) hesaba katarak geçerli zaman damgasını hesaplar. - Kategori ve slug değerlerini doğrular.
--jsonflag’i verildiğinde temiz, yapılandırılmış bir JSON çıktısı döner.
Yeni bir makale taslağı oluşturmak (scaffolding) için yapay zekanın hiçbir Hugo şablon kuralını bilmesine gerek kalmaz. Tek bir komut çalıştırması yeterlidir:
| |
Script 15 milisaniye içinde çalışır, dosyayı üretir ve JSON çıktısını verir:
| |
YAML biçimlendirmesini ya da saat dilimi matematiğini anlatmak için prompt’ta tek bir token bile harcanmamış olur.
4 AI Agent’ı Tarafından 12 Dakikada İnşa Edildi
Bu yaklaşımla ilgili sıkça karşılaşılan bir tereddüt vardır: “Sırf birkaç prompt token’ından tasarruf edeceğiz diye argüman ayrıştırma, doğrulama, hata yakalama ve JSON çıktısı sunan özel bir CLI yazmakla uğraşmaya değer mi?”
İşin püf noktası şu: Biz bu aracı elle yazmadık.
Gemini 3.8 Flash üzerinde çalışan 4 otonom AI agent’ından oluşan uzman bir ekip kurduk ve CLI’ı sıfırdan inşa etme görevini onlara verdik. Ekip projeyi yalnızca 12 dakikada tamamladı; üstelik araç daha ilk iterasyonda eksiksiz ve tamamen işlevsel biçimde hazırdı:
- Orchestrator: Agent iş akışını koordine etti, proje gereksinimlerini takip etti ve roller arasındaki geçişleri sorunsuz yönetti.
- Project Designer: CLI komut setini (
add,list,edit,publish,status), argüman flag’lerini, doğrulama kurallarını ve JSON şemalarını ayrıntılandırdı. - Developer: Flag ayrıştırma, ISO-8601 saat dilimi farkları, atomik dosya yazma işlemleri ve temiz JSON çıktıları dahil tüm Bash kod tabanını geliştirdi.
- Tester: Geniş kapsamlı bir otomatik test paketi hazırlayarak sınır durumları (edge cases) test etti ve her komutu tasarımcının teknik şartnamesine göre doğruladı.
Hızlı ve maliyet etkin bir modelle yapılan tek bir 12 dakikalık çalışma, deterministik ve kalıcı bir araç ortaya çıkardı. Bu tek seferlik yatırım, artık her içerik yazma, düzenleme veya yayınlama işleminde bize on binlerce token kazandırıyor.
Katman 2: Skill Dosyası (SKILL.md)
Bir sonraki adımda yapay zekanın CLI’ı nasıl kullanacağını bilmesi gerekir. Ancak kullanım kılavuzunun tamamını temel system prompt’a yapıştırmıyoruz.
Burada kademeli bilgilendirme (progressive disclosure) prensibini uyguluyoruz:
- Temel system prompt içinde yapay zeka, skill kayıt defterinde (registry) yalnızca 2 satırlık bir özet görür:Bu özet 40’tan az token harcar.
1 2name: tahablog description: Use this tool to create, edit, list, and publish content in tahamertgokdemir.com. - Kapsamlı operasyonel kılavuz ise diskte, ayrılmış bir skill dosyasında (
SKILL.md) saklanır. Yapay zeka bu dosyayı yalnızca ondan bir makale veya site içeriği üzerinde çalışmasını istediğinizde okur.
Skill dosyası dört net operasyonel kural tanımlar:
- Makale dosyalarını asla elle oluşturma. Taslağı her zaman
./tahablogkullanarak kur. - Flag’leri etkileşimsiz (non-interactive) ilet. Komutların kullanıcı girdisi beklemeden tamamlanması için
-n,-c,-sve--publishedflag’lerini kullan. - İçerikleri incelerken
--jsontercih et. Ham terminal çıktılarını okumak ya da ağır kabuk komutları çalıştırmak yerine derli toplu JSON çıktılarını ayrıştır. - Üstveriyi (metadata) içerikten ayır. Frontmatter’ı CLI’ın yazmasına izin ver; makale gövdesini ise bu başlığın hemen altına yaz.
Katman 3: İş Başındaki AI (Bu Makale Nasıl Yayınlandı?)
Yapay zekanın bu makaleyi yayınlarken takip ettiği adım adım iş akışı tam olarak şöyleydi:
- Görevi algıladı: Kullanıcı token optimizasyonu üzerine bir makale yazılmasını veya güncellenmesini istedi.
- Skill’i talep üzerine yükledi: Yapay zeka bunun bir içerik görevi olduğunu fark etti ve
SKILL.mddosyasını okudu. - Mevcut makaleleri inceledi: Mevcut makaleleri ve kategorileri denetlemek için
./tahablog article list --jsonkomutunu çalıştırdı (500+ token yerine yalnızca 74 token harcandı). - Taslak dosyayı oluşturdu: Başlık, slug, kategori ve tahmini okuma süresi parametreleriyle
./tahablog article addkomutunu yürüttü. - İçeriği yazdı: Üretilen dosyayı açtı ve metni doğrudan frontmatter başlığının altına ekledi.
- Kapak görselini yapılandırdı: Görsel varlığını üretti ve
./tahablog article editile--thumbnailalanını ayarladı.
Tüm süreç sıfır tahmin yürütme, sıfır bozuk YAML ve minimum prompt ek yükü ile tamamlandı.
3. Rakamlar: Öncesi ve Sonrası
Metodoloji: Token Tüketimini Nasıl Ölçtük?
Elde edilen tasarrufun gerçekliğini doğrulamak amacıyla prompt payload’larını, araç çalıştırmalarını ve çok turlu (multi-turn) diyalogları test ettik. Ölçümlerde, modern öncü modellerin (GPT-4, Claude ve Gemini dengi sistemler) standart tokenizer’ı olan cl100k_base kodlamasıyla OpenAI’ın tiktoken kütüphanesini kullandık.
Birebir aynı içerik yönetimi görevleri üzerinde iki gerçekçi iş akışını kıyasladık:
- Monolitik Prompting (Prompt Stuffing): Temel system prompt, statik site üretecinin tüm teknik özelliklerini, Hugo dizin yapılarını ve YAML şemalarını içerir (1.936 token’lık statik kurallar). İçerik denetimi için kabuk komutları çalıştırılır (
ls -lave dosya başlığı çıktıları). Makale taslağı oluştururken tüm frontmatter elle yazılır ve biçimlendirme sapmaları (geçersiz saat dilimi formatı veya YAML girinti hataları) her 25 turda bir hata düzeltme turunu tetikler (~3.200 token). - Tool + Skill Mimarisi: Temel system prompt yalnızca hafif bir skill kayıt girdisi barındırır (51 token). Kapsamlı skill rehberi (3.634 token) ise yalnızca bir içerik görevi geldiğinde talep üzerine bir kez yüklenir. İçerik denetimi yapılandırılmış CLI JSON çıktısını kullanır (
./tahablog article list --jsonile 74 token). Makale taslağı tek bir CLI komutuyla oluşturulur (87 token) ve deterministik doğrulama sayesinde biçimlendirme hatalarından kaynaklanan tekrar denemeler tamamen ortadan kalkar.
Deneysel Sonuçlar
| Metrik / İşlem | Monolitik Prompting | Tool + Skill Mimarisi | Fark |
|---|---|---|---|
| Temel System Prompt Ek Yükü | 1.936 token | 51 token | -%97,4 |
| İçerik Keşfi / Denetimi | 547 token (ls -la + başlıklar) | 74 token (./tahablog article list --json) | -%86,5 |
| Makale Taslağı & Frontmatter | 219 token (manuel YAML) | 87 token (CLI komutu + JSON) | -%60,3 |
| Skill Rehberi (Talep Üzerine) | Her turda yüklenir | 3.634 token (sadece yazarken yüklenir) | Diğer turlarda 0 token |
| Biçimlendirme & Saat Dilimi Hataları | %10–20 sapma (sözdizimi, saat dilimi, etiketler) | %0 (CLI doğrulamasıyla zorunlu kılınır) | Tamamen engellendi |
| Kümülatif 25 Turluk Oturum | 54.226 token | 5.379 token | 48.847 token tasarruf (-%90,1) |
| Kümülatif 50 Turluk Oturum | 108.452 token | 7.124 token | 101.328 token tasarruf (-%93,4) |
Kümülatif Tasarruf Neden Katlanarak Artar?
Agent iş akışlarında model, system prompt’u ve konuşma geçmişini her bir turda baştan değerlendirir.
50 turluk bir oturumda, 1.900 token’lık bir prompt vergisi tam 50 kez ödenir; bu da yapay zeka henüz görevinizi bile okumadan 95.000’den fazla token’ın boşa gitmesi demektir. Buna gereksiz dizin listelemelerini ve hata düzeltme döngülerini de eklediğinizde, context window hızla erir.
Tool + Skill deseninde ise temel turlarınız son derece hafif kalır (~50 token). Hacimli skill rehberi context’e yalnızca içeriğin fiilen üretildiği turlarda dahil edilir; böylece agent’ınız hızlı, ekonomik ve odaklanmış kalır.
4. Kendi Projeleriniz İçin Dört Temel Kural
Bu mimariyi dilediğiniz kod tabanına uygulayabilirsiniz:
1. Tekrarlayan işleri küçük script’lere devredin
Yapay zekanıza aynı klasör yapısını, dosya formatını veya derleme adımını ikiden fazla kez açıkladığınızı fark ederseniz, bunu yapmak yerine bir agent ekibine özel bir script veya CLI yazdırın. Üstelik bunu elle geliştirmeniz bile gerekmez; Gemini Flash gibi hızlı modellerle yapılacak kısa bir çalışma, güvenilir araçları dakikalar içinde üretebilir.
2. Script’lerin flag almasını sağlayın
Script’lerinizin etkileşimsiz (non-interactive) çalıştığından emin olun. Gerekli girdiler için (-n, -c veya --published gibi) flag’ler ekleyin ve agent’ın askıda kalmaması için etkileşimli istemlerden kaçının.
3. Temiz JSON çıktısı verin
Script’lerinize bir --json flag’i ekleyin. Yapay zekalar, ham terminal tablolarına veya yapılandırılmamış metin bloklarına kıyasla JSON verilerini çok daha hızlı, ucuz ve güvenilir şekilde ayrıştırır.
4. Talimatları talep üzerine yükleyin (Kademeli Bilgilendirme)
Tüm operasyonel kuralları ana system prompt’unuza veya temel yapılandırmanıza yığmayın. Ana prompt’unuzu kısa tutun ve ayrıntılı çalıştırma rehberlerini (runbook) yapay zekanın yalnızca ihtiyaç duyduğunda yükleyeceği modüler skill dosyalarında saklayın.
Özet
Yapay zeka ile daha verimli kod yazmanın yolu daha uzun prompt’lar kaleme almaktan geçmez. Asıl marifet; yapay zekaya basit araçlar ve net, kısa talimatlar sunabilmektir.
Bürokratik ve mekanik işleri yerel bir araca devrettiğinizde, on binlerce token tasarruf eder ve yapay zekanın tüm odağını asıl önemli olan noktaya yönlendirirsiniz: zor problemleri çözmek ve kaliteli yazılım geliştirmek.
Bu makalenin taslağı ./tahablog kullanılarak hazırlanmış ve içerik Tool + Skill deseni takip edilerek yazılmıştır.